← 사례 목록
업무 위임
알아서 일하는 에이전트
지시 한 문장이면 스스로 화면을 돌며 검증하고, 사람은 마지막 승인만 합니다.
1~2일 → 약 2시간확인 항목 400~500개를 한 바퀴 도는 시간
후보 131건 중 101건AI가 보고한 버그 후보 중 자동 재현 통과 (약 77%)
제품 2종 대상생성형 AI 제품 2종에서 도입 검증 중
처음 들은 문제
검증하는 사람은 저 혼자인데 맡은 제품은 여럿이었습니다. 새 버전이 나올 때마다 같은 화면들을 처음부터 다시 눌러봐야 했고, 더 근본적으로 — 생성형 AI 기능은 결과가 매번 달라서 "이 버튼을 누르면 이 화면이 나온다"식 각본 테스트가 성립하지 않았습니다.
실제 문제
각본을 더 쓰는 일이 아니라, 각본 없이 스스로 판단하는 검증자를 만드는 일이었습니다.
정해진 각본은 화면이 바뀌면 깨지고, 정답이 고정되지 않은 기능 앞에서는 애초에 쓸 수가 없습니다. 필요한 건 사람이 하듯 일하는 검증자였습니다 — 화면을 보고, 다음에 뭘 눌러볼지 정하고, 이상한지 스스로 판단하는.
정해진 각본을 더 쓰기
→스스로 판단하는 검증자 만들기
무엇을 만들었나
한 문장으로 지시→
AI가 스스로 반복 ⟳
화면 읽기→
다음 행동 정하기→
실행하고 기록
→
이상인지 판정확신도 함께 표시→
다시 나타나는지 확인약 77% 통과→
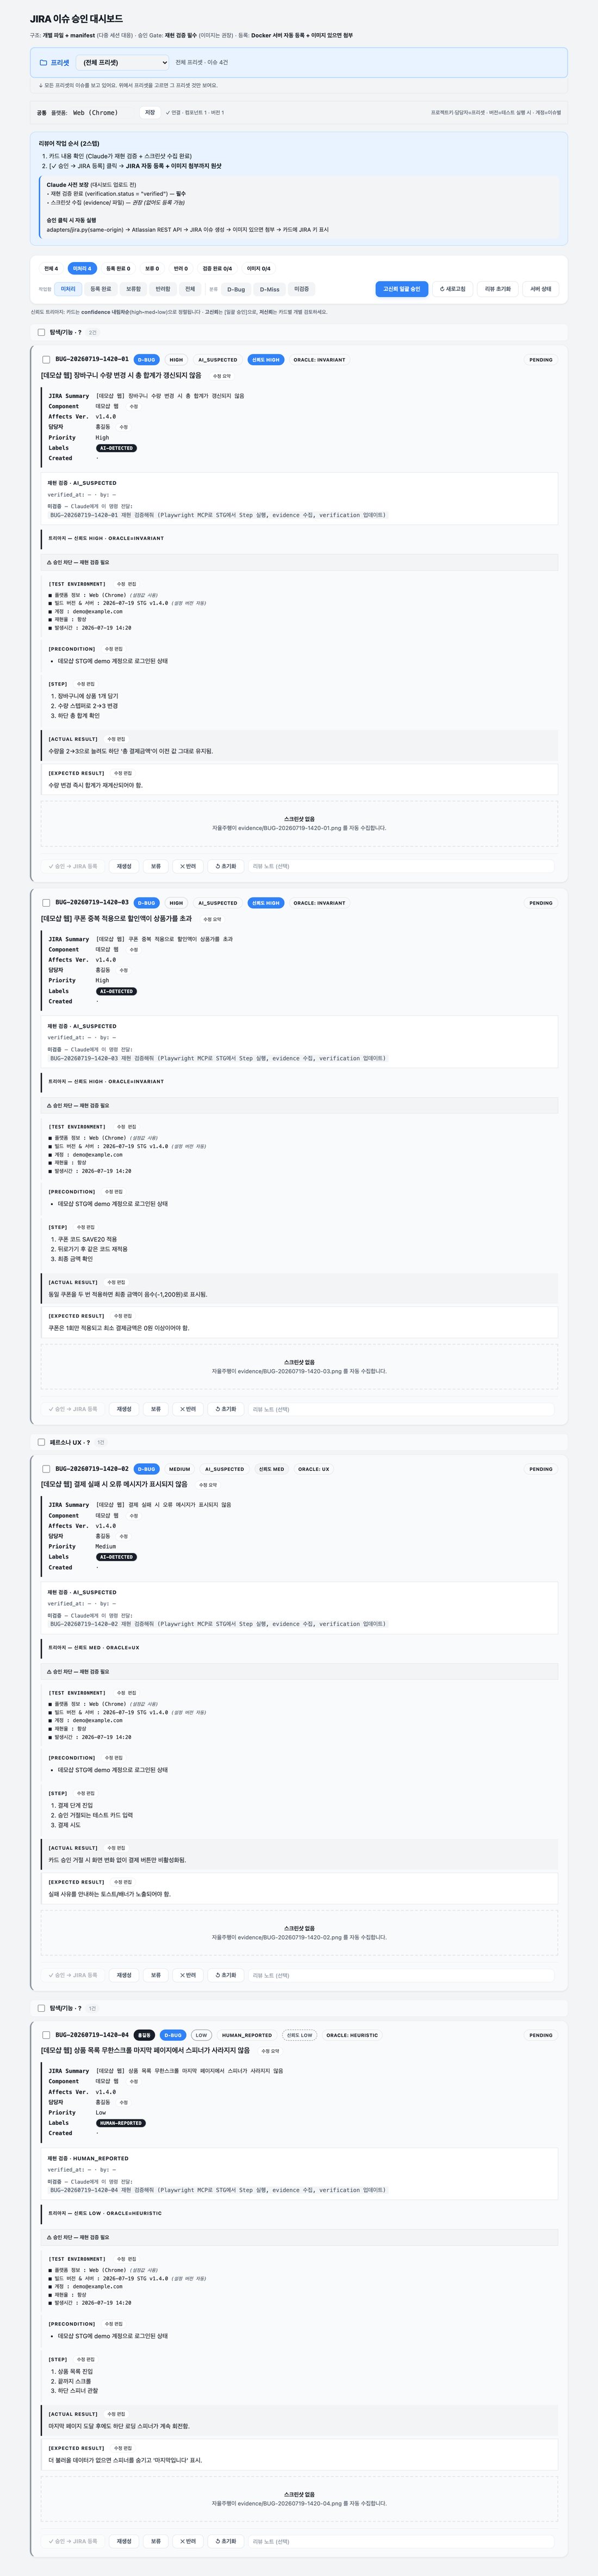
사람이 승인여기 한 곳→
이슈 등록
- 모드 두 개 — 회사의 실제 업무 방식을 그대로 따르는 모드(사내 문서 시스템에서 스펙을 조회해 테스트 산출물을 만들고 수행)와, 스펙이 없는 화면까지 검증하는 자율 탐색 모드
- 실행 과정 전체를 기록으로 남겨 판정의 증거로 쓰고, 찾은 문제는 자동으로 다시 재현해 확인합니다
- 중간에 멈췄다 이어서 하기, 실패 시 3번까지 다시 시도
어떻게 판단했나
- 화면 요소마다 "무엇을 시험할지"를 직접 정립했습니다.숫자 입력의 상한·하한, 시작일보다 빠른 종료일 같은 요소별 시험 목록과 판정 순서를 하나하나 쌓았습니다. 판정의 첫 분기는 "자연스러운 기대결과인가", 마지막 질문은 늘 같습니다 — 사용자에게 불편을 주는가.
- 애매한 것을 억지로 판정하지 않습니다.판정은 합격/불합격 둘이 아니라 "사람이 봐야 함"까지 셋입니다. 자동 재현이 흔들리면 기각하지 않고 확신도를 낮춰 사람 몫으로 넘깁니다.
- 결정은 AI가, 기록은 코드가 합니다.AI는 텍스트로 판정만 내리고 파일과 상태는 코드가 통제합니다. 근거 없는 확신은 스키마가 거부합니다 — "왜"를 못 대는 판정은 사람이 검토할 수도 없으니까요.
- 사람은 등록 직전, 딱 한 곳에만 둡니다.이슈 등록은 개발자의 시간을 쓰는, 되돌리기 비싼 행동이라서입니다. 이슈 양식과 스크린샷을 사람이 확인한 것만 개발자에게 갑니다.
결과
- 담당자의 일이 바뀌었습니다.이틀씩 화면을 붙잡고 눌러보던 일이, 아침에 지시 한 문장을 던지고 마지막에 승인 목록을 확인하는 일이 됐습니다.
- 사람이 1~2일 걸리던 확인을 약 2시간에 끝냅니다. 확인 항목 약 400~500개 기준으로 4~8배쯤 빨라졌습니다.
- AI가 보고한 버그 후보 131건 중 101건(약 77%)이 자동 재현을 통과했습니다. 버그로 확정된 정확도가 아니라 재현 관문을 통과한 비율이고, 승인 화면에 쌓인 데이터를 직접 집계한 숫자입니다.
- 생성형 AI 제품 2종에서 도입 검증 중입니다. 두 제품의 출시 검증을 혼자 감당하기 위해 만든 체계입니다.
사람이 확인하는 화면
쓴 기술PythonClaudePlaywrightMCP사례 검색(RAG)JIRA