← 사례 목록
AI 품질
AI 채점기 만들기
모델을 바꾸기 전에, 무엇이 좋아져야 하는지부터 정했습니다.
한 달 정체기술을 바꿔도 품질이 안 오르던 기간
4가지 기준품질을 나눠 재는 항목 (세부 6가지 추가)
평가 체계 v1작은 개선도 점수에 잡히는 첫 버전
처음 들은 문제
회사 제품 중에 AI가 SNS에 올릴 글을 대신 써주는 기능이 있습니다. 그 글의 품질이 한 달 넘게 제자리였습니다. 쓰는 모델도 바꿔보고 글을 만드는 순서도 다시 짰지만 나아지지 않았습니다.
실제 문제
기술이 부족한 게 아니었습니다. 회사 안에 "어떤 글이 좋은 글인가"에 대한 합의가 없었습니다.
기준이 없으면 무엇을 고쳐도 좋아진 건지 알 수 없습니다. 당시 채점 방식은 "문장이 어색한가"만 O/X로 보는 것이었습니다. 그래서 내용이 틀렸거나 설명이 부족한 글도 문장만 매끄러우면 통과했습니다. 게다가 채점을 AI에게 맡겼더니 점수를 후하게 주고 돌릴 때마다 결과가 달라져서, 이번 버전이 지난 버전보다 나은지 비교조차 할 수 없었습니다.
더 좋은 모델을 찾는 일
→좋은 글을 잴 수 있는 자를 만드는 일
어떻게 판단했나
- 제 눈이 아니라 회사의 눈을 기준으로 만들었습니다.경영진과 같은 글을 놓고 점수를 매겨 눈높이부터 맞췄습니다. 그 뒤로는 사람 평가와 어긋나는 패턴을 확인하고, 채점 지침과 예시를 반복해 보정했습니다. 점수를 후하게 주거나 특정 모델을 우대하는 편향이 보이면 그때그때 잡습니다.
- 기준을 묻지 않고, 고르게 했습니다."좋은 글의 기준이 뭐냐"고 물으면 아무도 답하지 못합니다. 대신 글 두 개를 나란히 놓고 "어느 쪽이 나은가"만 고르게 했습니다. 이건 누구나 답할 수 있습니다. 고른 결과를 모아서 기준을 거꾸로 뽑아냈습니다.
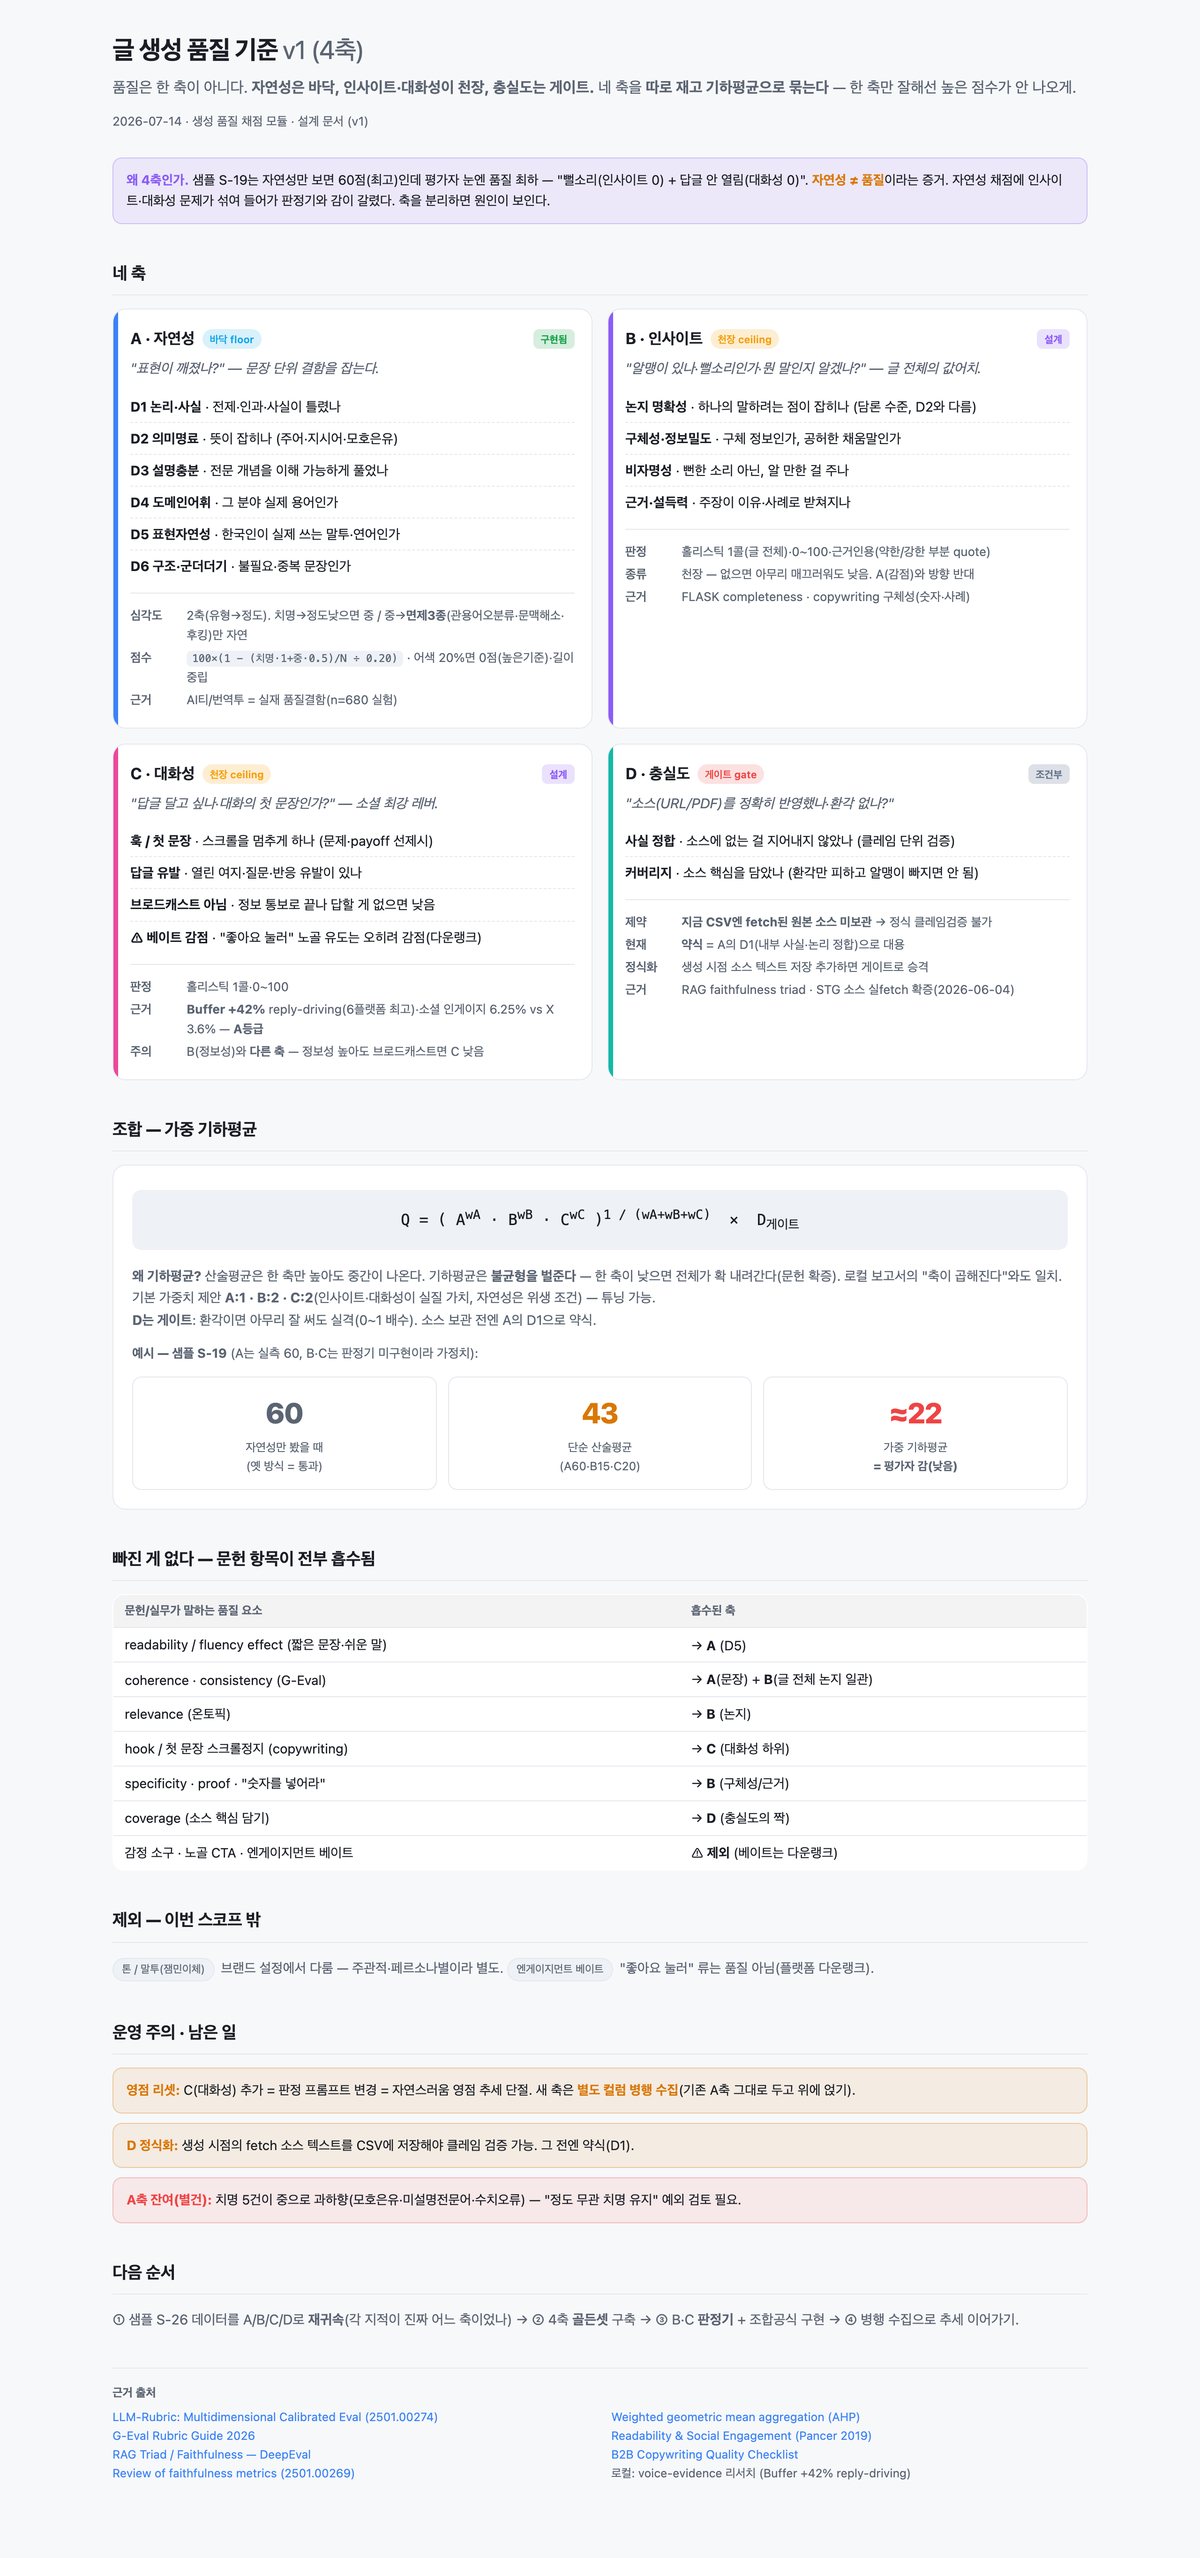
- 점수를 하나로 매기지 않았습니다.합격/불합격 하나로는 왜 나쁜지 설명할 수 없습니다. 품질을 네 가지로 나눠 따로 쟀고, 한 가지만 잘해서는 높은 점수가 나오지 않도록 묶었습니다.
- AI의 채점을 그대로 믿지 않았습니다.사람이 매긴 점수와 맞춰보고 어긋나는 부분을 보정한 뒤에야 실제 채점에 썼습니다.
무엇을 만들었나
- 글 두 개를 나란히 놓고 나은 쪽을 고르는 비교 화면 (같은 분야끼리 짝지어 비교)
- 네 가지 평가 기준: 얼마나 자연스럽게 읽히는가 · 새로운 관점이 있는가 · 반응이 오게 쓰였는가 · 사실에 맞는가
- 이 중 "자연스러움"을 다시 여섯 가지로 쪼갠 세부 항목 (앞뒤가 맞는가 / 뜻이 분명한가 / 설명이 충분한가 / 그 분야 말투인가 / 표현이 어색하지 않은가 / 군더더기가 없는가)
- 채점 근거를 반드시 글에서 인용하게 만든 채점 지침과, 사람 점수와 대조해 보정하는 절차
- 버전이 바뀔 때마다 같은 잣대로 다시 채점하는 구조
- 설계할 때 AI 평가 관련 공개 연구(FLASK · G-Eval · Prometheus 등)를 근거로 삼았습니다
결과
- 문장이 매끄러운 글이 좋은 글은 아니었습니다.자연스러움 점수가 가장 높았던 글이 전체 품질은 최하위였습니다. 읽기는 편한데 내용이 비어 있고 반응이 나올 구석이 없었습니다. 기준을 나누고 나서야 이게 보였습니다.
- "품질이 나쁘다"가 아니라 "무엇 때문에 나쁘다"를 짚을 수 있게 됐습니다.
- 작은 개선도 점수에 잡히는 평가 체계 첫 버전을 만들었고, 지금도 다듬고 있습니다.
- 따로 만든 콘텐츠 봇에서 확인한 글 도입부·마무리 배치 방식을 제안했고, 반영한 뒤 결과물이 나아졌습니다.
직접 설계한 기준 문서
쓴 기술PythonAI 채점(LLM-as-Judge)짝 비교 평가채점 기준 보정가중 기하평균 스코어링HTML